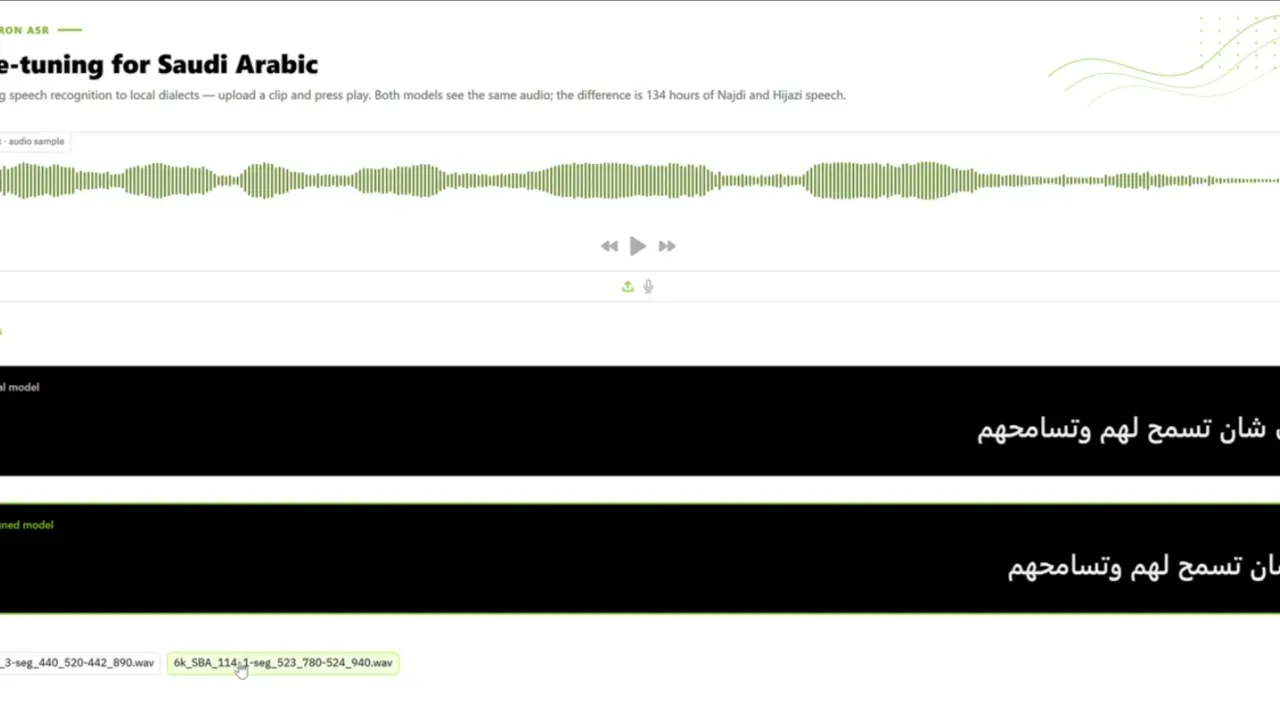



به گزارش کارگروه فناوری اطلاعات سایبربان؛ انویدیا (NVIDIA)، شرکت پیشروی جهانی در حوزه رایانش و هوش مصنوعی، اعلام کرد که برای آموزش مدل چندزبانه و خودکار تشخیص گفتار خود با نام «Nemotron 3.5 ASR»، از مجموعه داده صوتی عربی عربستان استفاده کرده است؛ مجموعهای که توسط سازمان داده و هوش مصنوعی عربستان (SDAIA) و با مشارکت سازمان رادیو و تلویزیون این کشور (SBA) راهاندازی شده است.
براساس یک مطالعه فنی منتشر شده در وبلاگ توسعهدهندگان انویدیا، ادغام این مجموعه داده باعث شد خطاهای درک گفتار برای لهجههای عربستانی تقریباً به نصف کاهش یابد. این مدل از تبدیل گفتار به متن (رونویسی) بهصورت سریع برای حدود ۴۰ زبان و لهجه، از جمله عربی، پشتیبانی میکند.
خیص حدود ۵۵ کلمه از هر ۱۰۰ کلمه در لهجههای عربستانی دچار اشتباه میشد، اما پس از آموزش با استفاده از ۱۳۳.۷ ساعت فایل صوتی با لهجههای «نجدی» و «حجازی»، نرخ خطای کلمه به حدود ۳۰ درصد کاهش یافت. در کلِ مجموعه داده چندلهجهای، نرخ خطا از ۵۸.۸ درصد به ۳۵.۶ درصد و نرخ خطای سطح کاراکتر از ۳۱.۶ درصد به ۱۲.۲ درصد رسید.
کارشناسان معتقدند که عملکرد مدل در زمینه عربی معیار مدرن و انگلیسی نیز بهبود یافت. فرآیند آموزش تنها 4 ساعت و نیم و با استفاده از دو پردازنده گرافیکی (GPU) انجام شد. این مدل ارتقا یافته که برای سیستمهای تعاملی سریع بهینهسازی شده، تأخیر اولیهای معادل ۸۰ میلیثانیه دارد و امکان استفاده در کاربردهایی نظیر دستیارهای صوتی هوشمند، عاملهای مکالمهگر، زیرنویسگذاری پخش زنده و رونویسی مکالمات مراکز تماس، آرشیوهای رسانهای و جلسات را فراهم میکند.
انویدیا همچنین گردشهای کاری و ابزارهای لازم را در اختیار توسعهدهندگان سراسر جهان قرار داده تا بتوانند این روششناسی را برای سایر زبانها نیز اجرا کنند.
سازمان داده و هوش مصنوعی عربستان پیشتر این مجموعه داده صوتی را در پلتفرم «Kaggle» منتشر کرده بود تا از پژوهشگران و توسعهدهندگان بینالمللی حمایت کند. این مجموعه داده شامل حدود ۶۶۷ ساعت فایل صوتی رونویسیشده است؛ از جمله بیش از ۶۰۰ ساعت محتوای ارائهشده توسط سازمان رادیو و تلویزیون عربستان که از ۵۷ برنامه و سریال تلویزیونی گردآوری شده و بیش از ۱۰ لهجه عربستانی را پوشش میدهد. ۲۰ ساعت دیگر از این مجموعه نیز به مرحله اعتبارسنجی اختصاص یافته است. این مجموعه داده که از بیش از ۱۲۵ هزار کلیپ طبقهبندیشده تشکیل شده، به انویدیا امکان داد تا دادههای گفتاری خاص لهجههای نجدی و حجازی را هدف قرار دهد.
ابتکار «مجموعه داده صوتی عربی عربستان» از تلاشهای علمی و فنی برای توسعه مدلهای صوتی پیشرفته در زمینههای تشخیص گفتار، تبدیل متن به گفتار، تفکیک گوینده و طبقهبندی جمعیتشناختی پشتیبانی میکند. این امر همچنین به غنای محتوای دیجیتال عربی کمک میکند.
به گفته کارشناسان، بهکارگیری این مجموعه داده توسط انویدیا، نقش حیاتی دادههای ملی باکیفیت را در کمک به سیستمهای جهانی هوش مصنوعی برای درک بهتر گویشهای محلی و ارتقای فناوریهای متناسب با گویشوران زبان عربی برجسته میسازد.